
Il controllo dell’utilizzo degli LLM si riferisce all’insieme di pratiche architetturali, finanziarie e operative che consentono alle aziende di monitorare, limitare e ottimizzare il modo in cui i Large Language Model vengono utilizzati. Comprende la governance dei token, il caching semantico, il rate limiting e l’osservabilità in tempo reale, tutti volti a trasformare la spesa AI da una variabile imprevedibile in un asset strategico e gestibile.
La rapida integrazione dei Large Language Model (LLM) nei contesti aziendali ha spostato il dibattito da ciò che è possibile fare a ciò che è sostenibile implementare.
Mentre le prime strategie in ambito LLMOps erano incentrate sul contenimento immediato dei costi, l’attuale pressione fiscale richiede una transizione verso una disciplina architettonica di livello aziendale, FinOps e governance operativa.
Per i dirigenti, la sfida principale non è più solo l’accuratezza del modello, bensì la volatilità di un pricing model in ambito LLM basato sul consumo – un sistema dinamico che rende difficile prevedere, allocare e giustificare la spesa per l’AI. A differenza delle licenze SaaS tradizionali, infatti, i costi LLM sono granulari e fluttuano in base alla densità dei token, alla complessità dei prompt e ai costi nascosti della retrieval-augmented generation (RAG).
Per evitare che l’AI diventi un centro di costo illimitato, le aziende devono andare oltre la contabilità reattiva e implementare un livello di governance proattivo, sfruttando un AI Gateway che tratti i token come una risorsa limitata e gestibile, completamente integrata nella più ampia strategia finanziaria aziendale.
È qui che la governance dei costi dell’AI diventa un fattore di differenziazione strategico: le aziende in grado di misurare, controllare e ottimizzare il consumo di LLM cresceranno infatti più rapidamente e con minori rischi operativi.
Questo passaggio verso l’ottimizzazione dei costi dell’AI a livello aziendale viene realizzato attraverso un approccio multilivello che allinea l’esecuzione tecnica, come il caching e il throttling, con risultati specifici.
Fasi di Implementazione e Principali Vantaggi
L’implementazione di un solido livello di controllo dell’utilizzo degli LLM consente alle aziende di raggiungere l’eccellenza operativa attraverso un approccio strutturato che correla direttamente le azioni tecniche con i vantaggi strategici. Seguendo questi passaggi, le aziende possono ottenere significativi benefici organizzativi:
- Monitoraggio in Tempo Reale: Garantisce l’efficienza finanziaria tracciando tutti gli input/output per una gestione precisa dei token e il controllo del budget.
- Applicazione delle Policy di Sicurezza: Assicura la sovranità dei dati filtrando le informazioni sensibili (PII) e prevenendo fughe verso provider esterni.
- Ottimizzazione dei Costi: Favorisce la sicurezza operativa prevenendo utilizzi non autorizzati attraverso limiti granulari di budget e risorse.
- Validazione degli Output: Garantisce la qualità verificando le risposte rispetto a criteri validati per mitigare il rischio di allucinazioni.
- Audit e Reporting: Mantiene l’allineamento normativo fornendo la documentazione necessaria per la conformità a standard come l’AI Act.
La tabella seguente riassume l’impatto strategico che queste misure di controllo hanno sul profilo AI complessivo dell’azienda:
| Beneficio | Impatto sull’Azienda |
| Efficienza Finanziaria | Riduzione delle spese operative attraverso una gestione precisa dei token e limiti di budget. |
| Sovranità dei Dati | Advanced protection of corporate intellectual property and sensitive user privacy. |
| Allineamento Normativo | Piena conformità con gli standard globali emergenti e i framework legali come l’AI Act. |
| Sicurezza Operativa | Prevenzione attiva degli utilizzi non autorizzati e mitigazione di rischi come la fuga dei dati sensibili. |
| Garanzia di Qualità | Maggiore affidabilità degli output AI attraverso validazione sistematica e controllo delle allucinazioni. |
Ridurre la spesa per l’AI con il Caching Semantico
Una delle soluzioni più immediate per il contenimento dei costi risiede nell’eliminazione dei calcoli ridondanti. In un ambiente aziendale tipico, una percentuale significativa delle query è ripetitiva o contestualmente simile. Il caching standard “exact match”, in cui il sistema restituisce un risultato memorizzato solo se la stringa di input è identica, è spesso troppo rigido per la natura fluida del linguaggio umano. Ed è proprio qui che il caching semantico diventa un imperativo strategico.
Utilizzando gli embedding vettoriali per calcolare una soglia di similarità, un AI Gateway può determinare se una nuova query è semanticamente equivalente a quella a cui è stata già data risposta in precedenza. Ad esempio, se un utente chiede “Come posso reimpostare la mia password VPN?” e un altro chiede “Qual è la procedura per reimpostare le credenziali VPN?”, una cache semantica riconosce l’intento condiviso.
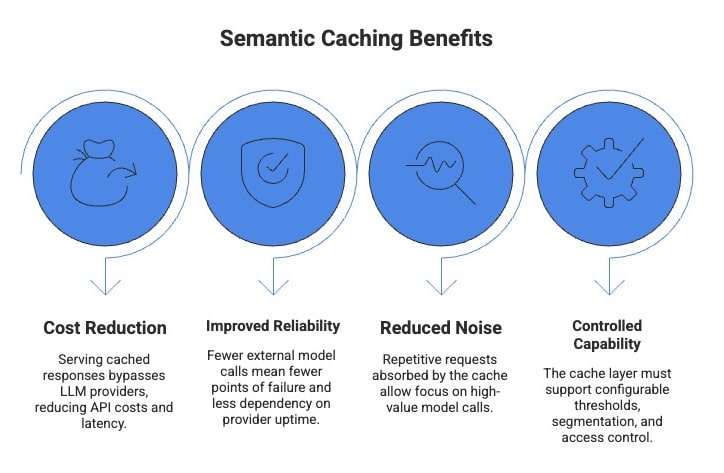
Fornire una risposta memorizzata nella cache consente alle aziende di bypassare completamente il provider LLM, riducendo quasi a zero i costi API per quella transazione e tagliando la latenza da secondi a millisecondi.
Implementando queste strategie di caching configurabili, l’azienda può quindi ridurre drasticamente le spese relative all’Intelligenza Artificiale e, allo stesso tempo, migliorare l’esperienza dell’utente finale grazie a tempi di risposta istantanei.
Il caching semantico introduce un elemento estremamente prezioso: la possibilità di evitare costi in modo prevedibile . Anziché limitarsi a ridurre l’utilizzo, l’azienda crea un meccanismo architetturale che previene attivamente le spese superflue. Una differenza fondamentale tra risparmio e ottimizzazione strategica..
Il caching semantico migliora anche l’ affidabilità. Un minor numero di chiamate a modelli esterni significa meno possibilità di errore, minore dipendenza dall’uptime del provider e meno picchi di latenza imprevedibili causati dalla congestione lato provider. In altre parole, il caching non è solo un livello di ottimizzazione, ma anche un livello di resilienza.
C’è anche un vantaggio di secondo ordine: il caching semantico riduce il rumore nei dati di osservabilità . Quando le richieste ripetitive vengono “assorbite” dalla cache, un’azienda può concentrare i propri sforzi di monitoraggio su chiamate di modelli ad alto valore che richiedono effettivamente ragionamento, recupero e generazione. Ciò rende l’analisi delle prestazioni più significativa e accelera la risoluzione dei problemi.
Tuttavia, il caching semantico deve essere considerato come una funzionalità controllata, non come una semplice soluzione rapida. Il livello cache deve supportare soglie di similarità configurabili, segmentazione consapevole dei tenant per evitare fughe di informazioni tra i reparti e integrazione del controllo degli accessi per garantire che le risposte memorizzate nella cache rispettino i limiti di autorizzazione.
Token Limiting Proattivo
L’imprevedibilità dei costi in ambito LLM è radicata nella black box della tokenizzazione . Poiché i modelli applicano tariffe in base al token , un’unità che non sempre è correlata in modo lineare al conteggio delle parole, una singola pipeline RAG non ottimizzata può inavvertitamente inserire migliaia di frammenti di documenti irrilevanti in un prompt, causando sorprese poco gradevoli per l’invoicing.
Per mitigare questo problema, i tech leader possono applicare un token limiting proattivo . Non si tratta semplicemente di un limite all’utilizzo: si tratta infatti un quadro normativo granulare che può essere applicato a livello globale, di modello, di team o di reparto.
Ad esempio, a un team di ricerca potrebbe essere concesso un limite massimo elevato per attività di ragionamento complesso, mentre un chatbot del servizio clienti è soggetto a un limite rigoroso per sessione per evitare dei “loop di allucinazioni” che esauriscono il budget.
Il token limiting è un modo diretto per applicare il controllo dei costi a livello di infrastruttura , consentendo alle aziende di passare da una revisione reattiva delle spese a una prevenzione proattiva. Riduce inoltre il rischio operativo, poiché iniezioni tempestive, agenti configurati in modo errato o flussi di lavoro incontrollati possono causare un consumo incontrollato di token e l’instabilità del sistema.
Il token limiting può anche migliorare la qualità dell’output , evitando prompt “gonfiati” e incoraggiando una progettazione più precisa dei prompt stessi. Le policy basate sui ruoli consentono di applicare limiti diversi in base all’identità e alla classe del modello, attraverso un AI Gateway che controlla attivamente l’utilizzo prima che venga chiamato il provider.
Inoltre, l’introduzione di meccanismi di throttling consente di livellare i picchi di utilizzo, garantendo la stabilità degli ambienti di produzione ad alta priorità anche durante periodi di domanda imprevista.
In combinazione con il rate limiting, che controlla la frequenza delle richieste per evitare picchi che compromettono le prestazioni o causano penalizzazioni da parte dei provider, questi controlli trasformano un flusso caotico di chiamate API in uno strumento prevedibile. Dare priorità all’utilizzo in base alle esigenze aziendali piuttosto che alla capacità puramente tecnica garantisce che le applicazioni mission-critical abbiano sempre il “tempo di trasmissione” necessario senza il rischio di sorprese finanziarie a fine mese.
Centralizzazione della Governance con l’AI Gateway di Radicalbit
In un ecosistema frammentato in cui più team possono utilizzare modelli diversi, una governance centralizzata è l’unica strada verso la scalabilità.
Questa è la proposta di valore specifica dell’ AI Gateway di Radicalbit . Agendo come un sofisticato centro di controllo per tutto il flusso di dati dei modelli, il Gateway fornisce il necessario livello di astrazione tra l’applicazione e il fornitore del modello. È all’interno di questa architettura che risiede la complessa logica del caching semantico, del request routing e del filtraggio di sicurezza.
Fungendo da hub centralizzato per l’ottimizzazione dei costi , l’AI Gateway di Radicalbit consente alle aziende di gestire e ridurre le spese AI attraverso un piano di controllo unificato che applica policy di limitazione e throttling in modo coerente all’intero inventario dei modelli.
L’unificazione del livello di controllo consente di implementare guardrail e politiche di risparmio sui costi a livello aziendale in un’unica posizione, indipendentemente dai modelli LLM sottostanti utilizzati. Questa scelta non solo protegge il flusso di dati, ma garantisce anche che il debito tecnico derivante dalla gestione di più chiavi API e cicli di fatturazione sia sostituito da un’ interfaccia controllata e verificabile .
AI Telemetry in Tempo Reale e Visibilità Predittiva
L’ultimo tassello del puzzle della gestione dei costi è la visibilità. La fatturazione cloud tradizionale spesso arriva con un ritardo di 30 giorni, il che è troppo lento per il mondo ad alta velocità della GenAI.
Una dashboard UI dedicata, integrata direttamente nell’ AI Gateway, fornisce telemetria in tempo reale sulle spese a livello di percorso, gruppo e utente. Questo framework di osservabilità e monitoraggio è essenziale per le operazioni di AI, consentendo alle parti interessate di accedere alle metriche di prestazioni e costi attraverso una dashboard in tempo reale che offre un quadro immediato dello stato di salute e dell’efficienza delle implementazioni di AI.
Questo livello di granularità consente ai responsabili finanziari di eseguire un’analisi del rapporto costo-valore in tempo reale. Se l’utilizzo di GenAI da parte del team vendite è raddoppiato, per esempio, la dashboard può individuare con precisione se tale aumento deriva da un modello specifico ad alto costo o da un aumento del volume degli utenti. Fondamentalmente, il collegamento di strumenti di osservabilità standard del settore garantisce che i dati specifici relativi all’IA non siano isolati, ma integrati in un ecosistema di monitoraggio IT più ampio, fornendo una visione olistica dell’impronta digitale dell’azienda.
Stabilire questa trasparenza facilita il passaggio a una visibilità predittiva , in cui le tendenze storiche vengono utilizzate per prevedere la spesa futura e definire con sicurezza i budget delle varie unità.
Scalare la Generative AI attraverso l’osservabilità strategica
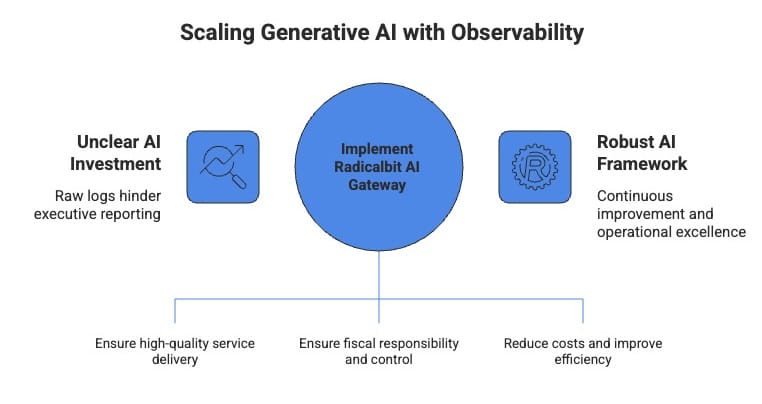
Per scalare efficacemente la Generative AI, le aziende devono considerare l’osservabilità non solo come uno strumento diagnostico, ma anche come una risorsa strategica. Colmando il divario tra i log API grezzi e il reporting finanziario a livello dirigenziale, l’AI Gateway di Radicalbit offre la chiarezza necessaria per giustificare ulteriori investimenti.
Di conseguenza, i team tecnici possono monitorare la latenza e i tassi di successo per garantire un servizio di alta qualità, mentre il reparto finanziario controlla i tassi di consumo per garantire una sostenibilità in termini finanziari e fiscali.
La sinergia tra la riduzione dei costi tramite caching e limiting , e il monitoraggio completo crea un solido quadro di riferimento per un miglioramento continuo.
Ad esempio, uno sviluppatore potrebbe notare tramite la dashboard che un modello specifico presenta prestazioni insufficienti in termini di latenza; può quindi utilizzare il Gateway per reindirizzare quel traffico o regolare i parametri di limitazione senza interrompere l’applicazione.
Questo livello di agilità è possibile solo quando le metriche relative alle prestazioni e ai costi vengono considerate come due facce della stessa medaglia. Sfruttando queste informazioni in tempo reale, le aziende possono iterare più rapidamente, passare dalla fase pilota alla produzione con un rischio minore e mantenere uno standard elevato di eccellenza operativa.
Creazione di un Modello Sostenibile per l’AI
Per ottenere un controllo sostenibile dell’utilizzo degli LLM è necessario superare il timore dei costi variabili e orientarsi verso un modello di surplus strategico. Quando un’azienda padroneggia l’arte del caching, del limiting e del monitoraggio, crea una sorta di effetto volano: i soldi risparmiati sulle query ridondanti vengono reinvestiti in casi d’uso più avanzati, come il fine-tuning o co-pilot specifici per dominio.
L’integrazione dell’ AI Gateway di Radicalbit, incentrato sull’ottimizzazione dei costi AI e sull’osservabilità, rappresenta più di un semplice aggiornamento tecnico: segna un cambiamento fondamentale nel modo in cui un’azienda interagisce con l’Intelligenza Artificiale.
Questa architettura fornisce i parametri di sicurezza che consentono alle aziende di accelerare con fiducia. Trattare l’utilizzo dell’AI con lo stesso rigore riservato a qualsiasi altra catena di approvvigionamento mission-critical garantisce che una strategia GenAI rimanga finanziariamente solida quanto tecnologicamente innovativa.
Fornire visibilità in tempo reale e controlli configurabili trasforma il percorso che porta da bollette esorbitanti a un’intelligence finanziaria utilizzabile in una roadmap tangibile per l’azienda moderna.
Sei pronto a ottimizzare la tua strategia AI? Trasformare la tua infrastruttura da un centro di costo imprevedibile a una risorsa strategica ad alte prestazioni inizia con una governance adeguata.
Visita la pagina dedicata all’AI Gateway di Radicalbit per saperne di più o contatta il nostro Team per programmare una demo personalizzata. Ti aiuteremo a intraprendere il tuo percorso verso una trasparenza dei costi radicale e l’eccellenza operativa.
Domande Frequenti sul Controllo dell’Utilizzo degli LLM
Il controllo dell’utilizzo degli LLM è la pratica di gestire le modalità di accesso e consumo dei Large Language Model all’interno di un’azienda. Attraverso meccanismi come il token limiting, il semantic caching, il throttling e il monitoraggio in tempo reale, la spesa per l’AI viene trasformata da variabile imprevedibile in un asset strategico.
Il semantic caching utilizza gli embeddings vettoriali per riconoscere le richieste che condividono lo stesso intento, anche se formulate in modo diverso. Quando viene individuata una corrispondenza, la risposta archiviata nella cache viene servita senza interpellare il provider dell’LLM, riducendo quasi a zero i costi API per quella transazione e abbattendo drasticamente la latenza di risposta.
Il token limiting stabilisce soglie massime di consumo a livello globale, di modello, di team o di singolo utente. Attività di ricerca ad alta complessità possono richiedere tetti di spesa più elevati, mentre i chatbot rivolti ai clienti beneficiano di limiti rigorosi per sessione per prevenire “loop” di allucinazioni incontrollate che prosciugano il budget.
Un AI Gateway fornisce un unico piano di controllo per applicare caching, limiti di token, throttling e policy di sicurezza su tutti i modelli e i provider. Ciò elimina l’onere di gestire molteplici chiavi API e cicli di fatturazione, offrendo un’unica interfaccia governata e verificabile.
No. Al contrario, se implementata correttamente, la accelera. I risparmi derivanti dal caching e dai limiti di token generano un “effetto volano”, liberando budget da reinvestire in casi d’uso più avanzati, come il fine-tuning o lo sviluppo di copilot specifici per un dominio, permettendo alle organizzazioni di scalare l’AI con sicurezza finanziaria.
Key Takeaways
- I costi degli LLM sono dinamici: la densità dei token, la complessità dei prompt e l’overhead del RAG rendono essenziale una governance proattiva per evitare “shock da fatturazione” imprevedibili.
- Il semantic caching è uno strumento sia di costo che di resilienza: elimina le chiamate API ridondanti, migliorando al contempo l’affidabilità e la qualità dell’osservabilità.
- Il token limiting sposta le imprese dalla revisione passiva della spesa alla prevenzione proattiva: permette di implementare policy basate sui ruoli, personalizzate per team e per modello.
- Un AI Gateway centralizzato è l’unico modello di governance scalabile: un unico piano di controllo verificabile per tutti i modelli linguistici, che sostituisce la gestione frammentata di API e fatturazione.

