
Per lungo tempo, la sovranità digitale è rimasta confinata nel perimetro dei dibattiti teorici: un imperativo etico privo, tuttavia, di un framework operativo immediato. L’avvento degli LLM ha ribaltato questo paradigma, trasformando l’autonomia tecnologica da concetto astratto a pilastro della strategia aziendale.
La Generative AI ha reso la dipendenza tecnologica dell’Europa visibile, misurabile e soprattutto urgente. Non si tratta più soltanto di sapere dove risiedono i dati aziendali o chi gestisce i datacenter: oggi si tratta di capire chi controlla i modelli con cui le nostre aziende ragionano, decidono e producono.
Il 2025 e il 2026 hanno accelerato questa presa di coscienza su più fronti contemporaneamente. A novembre 2025 tutti e 27 gli stati membri dell’Unione Europea hanno firmato la Declaration for European Digital Sovereignty, un atto politico senza precedenti che riconosce esplicitamente la dipendenza tecnologica come rischio strategico.
Nello stesso periodo sono entrate in vigore tre normative che toccano direttamente la catena tecnologica delle imprese: l’AI Act, con i primi obblighi per i sistemi GPAI operativi dall’agosto 2025; NIS2, che dal 2024 estende la responsabilità sulla sicurezza informatica a 18 settori critici (supply chain inclusa); e DORA che dal gennaio 2025 impone al settore finanziario requisiti stringenti sulla resilienza dei fornitori ICT terzi.
Il paradigma è cambiato: la questione è la provenienza infrastrutturale dell’AI, non più il suo mero utilizzo. Per le aziende data-driven, l’interrogativo è di chi sia effettivamente la tecnologia integrata nei propri stack core.
Il nodo dell’AI Generativa: una dipendenza strutturale
Quando parliamo di Generative AI in azienda, il panorama è dominato da un numero ristretto di attori: GPT di OpenAI, Gemini di Google, Claude di Anthropic, i modelli Llama di Meta. Tutti soggetti alla giurisdizione degli Stati Uniti: un dato geopolitico con implicazioni legali concrete.
Il CLOUD Act del 2018 obbliga le aziende statunitensi a fornire alle autorità americane l’accesso ai dati da esse gestiti, indipendentemente da dove questi dati siano fisicamente conservati. Un’azienda europea che invia dati a un’API americana per generare un testo o classificare un documento trasmette quei dati a un’infrastruttura soggetta a questa normativa. Non importa se il datacenter è in Europa: se il provider è americano, il CLOUD Act si applica.
Le soluzioni “sovereign” offerte dagli hyperscaler europei attenuano il problema ma non lo risolvono. Riducono i rischi di accesso fisico, ma non eliminano la giurisdizione americana sulla società madre. Come ha chiarito l’European Data Protection Board, i meccanismi di trasferimento dei dati verso gli USA rimangono strutturalmente fragili fino a quando questa asimmetria giuridica non viene affrontata alla radice.
Per la Generative AI il problema si amplifica: a differenza dello storage, i dati non “risiedono” solo in un luogo, ma vengono elaborati da modelli addestrati su corpus proprietari, con architetture non ispezionabili, da aziende che non rispondono alla legge europea.
Le aziende che integrano questi modelli nei loro workflow operativi stanno essenzialmente esternalizzando una parte del loro processo cognitivo a soggetti extra-UE.
Il gap europeo: cosa manca davvero
L’Europa non è assente dal panorama dell’AI, ma è onesto riconoscere dove si trovano i limiti strutturali.
Sul fronte dei modelli, il caso più significativo è Mistral AI: startup francese e modelli open source di qualità. Un simbolo della capacità europea di competere sull’innovazione. Eppure anche Mistral distribuisce i propri modelli attraverso Azure e AWS, un paradosso che deriva dal mercato: senza una base di clienti enterprise europea abbastanza grande e organizzata, anche i player europei migliori devono appoggiarsi all’infrastruttura americana per scalare.
Sul fronte del calcolo, la dipendenza è ancora più profonda. I chip necessari per addestrare e fare inferenza con modelli di grandi dimensioni (le GPU NVIDIA) sono progettati negli Stati Uniti e prodotti da TSMC a Taiwan. L’Europa non ha attualmente capacità di produzione autonoma per questa tipologia di semiconduttori. Il Chips Act europeo punta al 20% della produzione mondiale entro il 2030, ma siamo ancora lontani da quella soglia, e l’addestramento dei modelli di frontiera richiede cluster di migliaia di chip oggi, non tra anni.
Sul fronte dell’infrastruttura HPC, l’Europa ha investito significativamente: il supercomputer Leonardo di CINECA a Bologna è tra i dieci più potenti al mondo; LUMI in Finlandia, Jupiter in Germania e MareNostrum 5 a Barcellona completano un ecosistema europeo ad alte prestazioni. Il programma EuroHPC ha distribuito risorse di calcolo per la ricerca e per progetti industriali. Ma l’accesso a questi sistemi rimane prevalentemente accademico e la distanza con le capacità di inferenza dei grandi cloud provider americani, disponibili via API in pochi secondi, è ancora enorme in termini di accessibilità operativa.
Il risultato è una situazione ibrida: l’Europa ha competenze, talenti e volontà politica, ma non ha ancora una filiera completa e accessibile per le aziende che vogliono usare l’AI in produzione senza dipendere dai provider americani.
La risposta possibile: non sostituire, ma disaccoppiare
Sarebbe controproducente suggerire alle aziende europee di smettere di usare i modelli americani. GPT e i suoi equivalenti sono strumenti potenti, disponibili oggi, con ecosistemi maturi. Il problema non è usarli: è dipendere esclusivamente da loro, senza la capacità di cambiare, controllare o portare in altro luogo i propri workflow.
La strategia più efficace non è quindi la sostituzione, ma il disaccoppiamento.
Un’architettura che disaccoppia le applicazioni aziendali dai modelli specifici introduce un layer intermedio, spesso chiamato AI Gateway o Proxy Layer, che gestisce il routing delle richieste verso diversi provider, applica policy di governance sui dati in transito, monitora i costi e garantisce l’osservabilità dei sistemi.
I vantaggi di tale approccio sono concreti:
- Flessibilità multi-provider: se oggi un’azienda usa GPT per la sintesi documentale e Mistral per la classificazione interna, domani può aggiungere un modello open source ospitato on-premise senza riscrivere il codice applicativo. Il gateway astrae il modello dall’applicazione.
- Governance dei dati: un gateway ben configurato può rilevare e mascherare automaticamente le informazioni sensibili, come dati personali, numeri di conto e informazioni riservate prima che lascino il perimetro aziendale. Questo non risolve il problema giuridico del CLOUD Act, ma riduce drasticamente la superficie di rischio.
- Controllo dei costi: la proliferazione non governata degli LLM in azienda, il fenomeno noto come AI Sprawl (per approfondire l’argomento, leggi il nostro blog post dedicato), porta a spese difficili da tracciare e ottimizzare. Un gateway centralizzato permette di assegnare budget per team, progetto o use case, e di implementare meccanismi di caching semantico che riducono le chiamate ridondanti.
- Osservabilità e qualità: sapere come i modelli vengono usati, con quali prompt, con quali esiti, è essenziale per garantire la qualità e per identificare usi anomali, inclusa la Shadow AI (per approfondire l’argomento, leggi qui), cioè l’uso non autorizzato di LLM da parte dei dipendenti con dati aziendali sensibili.
Questo approccio è compatibile con i requisiti di NIS2 (tracciabilità e gestione del rischio nella supply chain), DORA (resilienza dei fornitori ICT terzi) e AI Act (obblighi di logging e monitoraggio per i sistemi ad alto rischio).
Radicalbit AI Gateway: un approccio concreto al disaccoppiamento
L’AI Gateway di Radicalbit è pensato esattamente per questo tipo di architettura: un layer di orchestrazione che si inserisce tra le applicazioni aziendali e i modelli AI, indipendentemente dal provider.
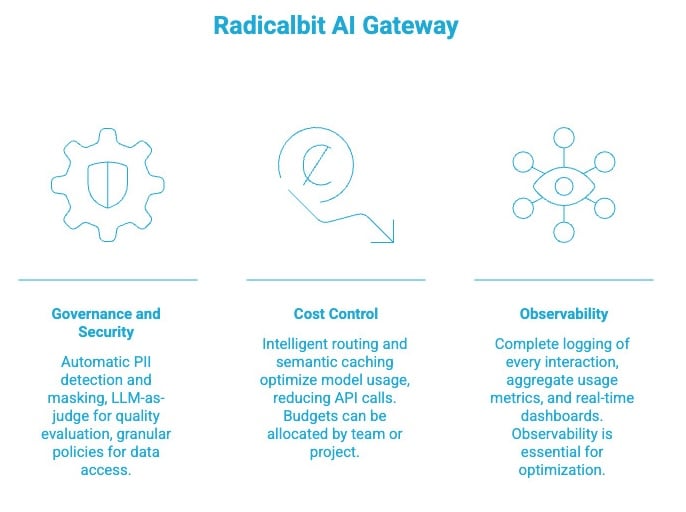
Il prodotto è costruito attorno a tre pilastri:
- Governance & Security: l’AI Gateway include funzionalità di rilevamento e mascheramento automatico dei dati PII prima dell’invio al modello. Integra meccanismi di LLM-as-judge per la valutazione automatica della qualità delle risposte, e permette di definire policy granulari su quali dati possono essere inviati a quali provider. Per le aziende soggette a NIS2, DORA o all’AI Act, questo livello di controllo è diventato un requisito operativo, non un’opzione.
- Cost Control: attraverso il routing intelligente e il caching semantico, il Gateway ottimizza l’utilizzo dei modelli. Le richieste simili vengono servite dalla cache, riducendo le chiamate API. I budget possono essere allocati per team o progetto, con alert configurabili.
- Observability: Logging completo di ogni interazione, metriche aggregate sull’utilizzo per modello e per team, dashboard in tempo reale. L’osservabilità è il presupposto per qualsiasi strategia di ottimizzazione: non si può infatti governare ciò che non si vede.
Sul piano tecnico, l’AI Gateway di Radicalbit espone un’interfaccia compatibile con le API OpenAI, il che significa che le applicazioni già integrate con GPT non richiedono modifiche al codice per passare attraverso il layer di orchestrazione. Il routing verso provider diversi (OpenAI, Anthropic, Mistral, Llama in locale, o qualsiasi endpoint compatibile) si configura tramite file YAML, senza interventi applicativi.
Questo design risponde direttamente al problema del vendor lock-in: l’applicazione non sa e non deve sapere quale modello sta usando. La scelta del modello diventa una decisione di governance, non un vincolo architetturale.
Per maggiori informazioni sulla nostra soluzione, consulta la pagina dedicata all’AI Gateway di Radicalbit.
La Sovranità Digitale si costruisce un layer alla volta
La sovranità digitale nell’era dell’AI non è un obiettivo che si raggiunge con una singola decisione: migrare tutto on-premise, abbandonare gli hyperscaler americani, aspettare che l’Europa produca i propri modelli di frontiera. Nessuno di questi scenari è realistico nel breve termine.
La sovranità si costruisce riducendo progressivamente i punti di dipendenza non necessaria e aumentando la capacità di controllo, osservabilità e portabilità.
Sul fronte normativo, l’Europa sta facendo la sua parte: l’AI Act definisce obblighi precisi; NIS2 e DORA estendono la responsabilità lungo la supply chain tecnologica; la Declaration for European Digital Sovereignty segnala una volontà politica che non esisteva cinque anni fa.
Sul fronte industriale, ogni azienda che adotta un’architettura multi-provider, che implementa una governance centralizzata degli LLM, che sceglie soluzioni europee quando disponibili e competitive, contribuisce a costruire la domanda aggregata che rende possibile lo sviluppo di alternative.
Il layer di orchestrazione non è la soluzione completa al problema della sovranità digitale. Ma è uno dei pochi strumenti concreti, disponibili oggi, che permette alle aziende di iniziare questo percorso senza aspettare che l’ecosistema europeo raggiunga la maturità degli hyperscaler americani.
Riprendere il controllo significa sapere dove si trovano i propri dati, chi li elabora, e avere la capacità di cambiare rotta se le condizioni cambiano.
Scopri come funziona l’AI Gateway di Radicalbit e prenota una demo per vedere come disaccoppiare le tue applicazioni dai provider, governare i dati in transito e costruire un’architettura AI sovrana e resiliente.

